从一个向量开始,我注意到了Transformer
更新日志
2026.10.05:博客创建
2026.10.06:完成第0、1、2章。
0. 怎么读这篇博客
阅读博客之前,请先阅读以下内容。
0.1 这套博客要回答什么问题
- 零基础入门人工智能要学什么基础知识?
- Transformer 是什么?
- 它为什么能处理语言?
- 它是怎么学会预测下一个词的?
- ChatGPT 这类模型怎么根据输入生成文字?
0.2 读者需要什么基础
本博客属于杂谈随笔,旨在记录本人如何从零基础入门人工智能领域,会从数学原理讲起,不过最基本的线性代数、微积分概念不予讲解,但涉及到的重要知识或者内容会进行补充,所以请在基本学完本科阶段线性代数、微积分之后并确保有基本的矩阵知识、微积分知识后进行阅读。
关于编程基础,懂得基本 Python 的语法即可。涉及到的 PyTorch 语句语法会给出对应的介绍以及讲解,所以可以不用担心没学过。
0.3 读前须知
阅读顺序可以直接从 Transformer 章节进行阅读。因为本人学的过程就是直接读 Transformer 的开山论文,然后采用深度优先学习法,遇到不会的、未接触的知识,再去学这个知识,直到学到底层后递归向上。所以阅读过程可以直接从 Transformer 章节进行阅读,涉及到的相关知识在前述章节会给出,可以点击进行查看。并不建议读完前面所有基础内容再学 Transformer,因为可能学完之后就忘记了。所以建议这种深度优先学习的方法。博客在编写过程中也会确保知识点出现过程中的相关介绍补充以及扫盲。
1. 计算机怎样处理文字
这一部分指的是将人类文字变成计算机可以看懂的输入,然后输入到计算机中,经过处理之后再输出成文字的过程。读完这部分后,我们应该可以区分字符编码、Token 切分和 Token ID 这些概念,知道信息在机器处理过程中的基本状态是什么。
1.1 字符、编码与数字
我们在屏幕上看到一个文字,例如“猫”时,作为一个客观存在的、有着自主思维的人类来讲,我们将“猫”这个文字作为载体存储到我们的大脑中,但计算机的存储以及信息的表示都基于一串又一串的二进制编码形成的数字,它在面对“猫”这个字的时候,通过已有的文本字符编号,将“猫”这个字映射到编号上,然后通过编码方式将编号映射成字节序列。
在这里要分清楚三个层次:
| 层次 | 例子 | 作用 |
|---|---|---|
| 人看到的文本 | 猫 | 人类阅读的文字 |
| 字符编号 | Unicode 中对应的码点 | 在字符层面标识字符 |
| 编码后的字节 | UTF-8 字节序列 | 供计算机存储和传输 |
比如我们得到一个字符“猫”,然后得到它的 Unicode 编号 U+732B,最后通过 UTF-8 编码方式得到对应的字节序列 E7 8C AB。这样我们就得到了一个字符如何转换为计算机可存储、表示的形式。
但这还不是 Transformer 所说的 Token 切分。字符编码解决的是将字符映射成计算机可理解的字节序列,使之可以表示和保存。Tokenizer 解决的是模型将输入的文本切分成多个处理单元。可以理解为一个重在将文本转化为可存储表示的字节,一个将字符切分为不同的 Token。具体可读下文。
1.2 Token
Token 是模型词表中的一个基本单位。它可能是一个完整的单词,或者一段单词,亦可是一个汉字、多个汉字,标点、空格等等。甚至某些字节片段中,Token 不一定是一个“词”,这由分词器 Tokenizer 决定。通常不同模型的 Tokenizer 处理同一段文本也可以得到不同的切分结果。
例如,把“我喜欢浙江工业大学”交给不同的 Tokenizer,可能得到这样的切分结果:
| 切分方式 | Token 序列 |
|---|---|
| 一种可能 | ["我", "喜欢", "浙江工业", "大学"] |
| 另一种可能 | ["我", "喜欢", "浙江", "工业", "大学"] |
切分没有对错之分,也可能更细或更粗;实际结果由具体模型的 Tokenizer 决定。
为什么不直接一个字、一个单词就是一个 Token 呢?因为按字符切分会让 Token 序列变得很长,按完整词切分则会遇到词表过大、罕见词或新词难以处理的问题,子词切分让词表规模、序列长度之间做折中,也让模型通过熟悉的片段组合处理罕见的、未见得词性。
Token 数量会影响模型可处理的上下文长度以及计算量,同样长度的一段文字,切分的 Token 越多,占用的上下文通常越多。Token 是模型处理和理解世界的基本单位。
1.3 Token ID
Tokenizer 切分 Token 后,会查一张表,我们称之为词表,词表中把每个 Token 映射成一个整数,称之为 Token ID。假设现在存在一个词表如下:
示意词表(内容仅作说明,无具体含义)
| Token | Token ID | Token | Token ID |
|---|---|---|---|
| 我 | 0 | 喜欢 | 1 |
| 浙江 | 2 | 工业 | 3 |
| 大学 | 4 | 和 | 5 |
| 今天 | 6 | 明天 | 7 |
| 晴天 | 8 | 阴天 | 9 |
| 天气 | 10 | 下雨 | 11 |
| 机器 | 12 | 学习 | 13 |
| 很好 | 14 | 。 | 15 |
如果我们得到一个 Token 序列为 [“今天”, “天气”, “很好”],对应的词表中的 Token ID 为[6, 10, 14]。
当然这些数字只是示意,真实的编号由具体模型自身的词表决定。Token ID 的作用就是告诉程序该查哪一个 Token,并不表示一个 Token 多重要,编号距离相近也不影响 Token 之间的关系,同时不具有数值特征,不能说 “15” 就比 “4” 大或者好,仅仅表示一个离散的编号。
这里还要区分 Token ID 与模型实际计算的表示,ID只是离散的编号;进入神经网络后,模型会通过 Embedding 表把每个 ID 嵌入成一个向量,这个向量才是后续矩阵运算以及各种运算的输入。本文将在神经网络基础部分再细讲 Embedding。
Token ID 依赖 Tokenizer 的词表,因此同一个字符串交给不同的 Tokenizer 时可能会得到不同的切分结果以及不同的词表,因此使用一个预训练模型时必须配套的使用与之匹配的 Tokenizer。
1.4 特殊 Token 与词表
词表是 Token 与 Token ID 之间的映射表。模型输入时将 Token 转化为 ID,紧接着嵌入成向量,输出时也通常会词表里面的候选 Token 计算分数或概率。词表大小因此影响输出层的规模,可以理解为模型的 Token 候选集。
除了普通文本段外,词表或者输入协议中还包含特殊Token,例如:
| 特殊 Token | 英文含义 | 作用 |
|---|---|---|
BOS |
Beginning of Sequence | 标记输入或生成序列的开始 |
EOS |
End of Sequence | 标记序列结束 |
PAD |
Padding | 补齐不同长度的序列,便于批量处理 |
UNK |
Unknown | 表示无法识别或表示的 Token;有些 Tokenizer 会尽量避免使用 |
当然不同模型不一定全部使用这些特殊标记,也不一定只含有这几个标记,这由具体的 Transformer 而定。
PAD Token 和后面要讲的 Attention Mask 也要区分开来。前者指的是一个填充位置可能使用的 Token,因为在把 Token 序列化为等长的时候,较短的序列可能采用 PAD 填补空缺;Mask 则是告诉模型应该的遮罩,即哪些位置信息应该被屏蔽。Mask 具体由后文的注意力机制章节展开讲解。
有了 Token 序列,就可以定义语言模型最常见的训练任务:给定前面的 Token,预测接下来那个 Token。注意,目标是下一个 Token,不一定是下一个完整单词,因为一个词可能被切成多个 Token。
比如一句话被切成[“我”, “喜欢”, “浙江”, “工业”, “大学”],训练时过程如下:
| 已有上下文 | 要预测的下一个 Token |
|---|---|
BOS |
我 |
BOS, 我 |
喜欢 |
BOS, 我, 喜欢 |
浙江工业 |
BOS, 我, 喜欢, 浙江工业 |
大学 |
BOS, 我, 喜欢, 浙江工业, 大学 |
EOS |
模型学习的就是,看到已有上下文之后,预测下一个 Token 中哪一个更可能出现。比如看到 “BOS, 我, 喜欢” 之后,开始对下一个可能的 Token 进行预测,每个候选 Token 用概率记号可以写成:
$$
P(t_{i+1}\mid t_1,\ldots,t_i)
$$
这里,$t_1,\ldots,t_i$ 是已经出现的 Token,$t_{i+1}$ 是要预测的下一个 Token。公式的读法、下标和条件概率会在后面的符号与数学基础部分拆开讲。
举例说明,我们已有的 Token 上下文为 “BOS, 我, 喜欢”,可能得到的候选集如下:
假设在上下文 BOS, 我, 喜欢 下,模型得到以下示意概率:
| 候选下一个 Token | 条件概率 |
|---|---|
浙江工业 |
0.40 |
学习 |
0.20 |
你 |
0.15 |
运动 |
0.10 |
浙江大学 |
0.10 |
| 其他候选 | 0.05 |
当然这个表只是用于演示假设的概率表,仅用作说明。其中 浙江工业 出现的概率最高,所以它是最可能出现的下一个 Token,所以选择它。
这里补充一句,贪心解码中就是选概率最大的,但这不是唯一的方法。实际生成中可能按概率随机抽,也可能筛一部分再抽,具体由解码策略决定。所以并不一定就是说就选概率最大的,不过这里以它为例进行演示。
在实际训练过程中,模型通常能在一次计算中处理序列的多个位置,并同时预测多个 “下一个 Token”,实现并行运算。工作原理就是通过因果 Mask,限制每个位置智能利用允许看到的上下文,而不会偷看后面的位置进行“作弊”。具体 Mask 矩阵将在后文细讲。
生成文字时,模型从已有上下文计算下一个 Token 的概率分布,选出一个 Token 并接到末尾,再用更新后的上下文预测下一步。重复这个过程,Token 序列逐渐变长完成整个序列的预测,之后 Tokenizer 再将 Token 序列还原成人能阅读的文本。
完整的数据流见下图:
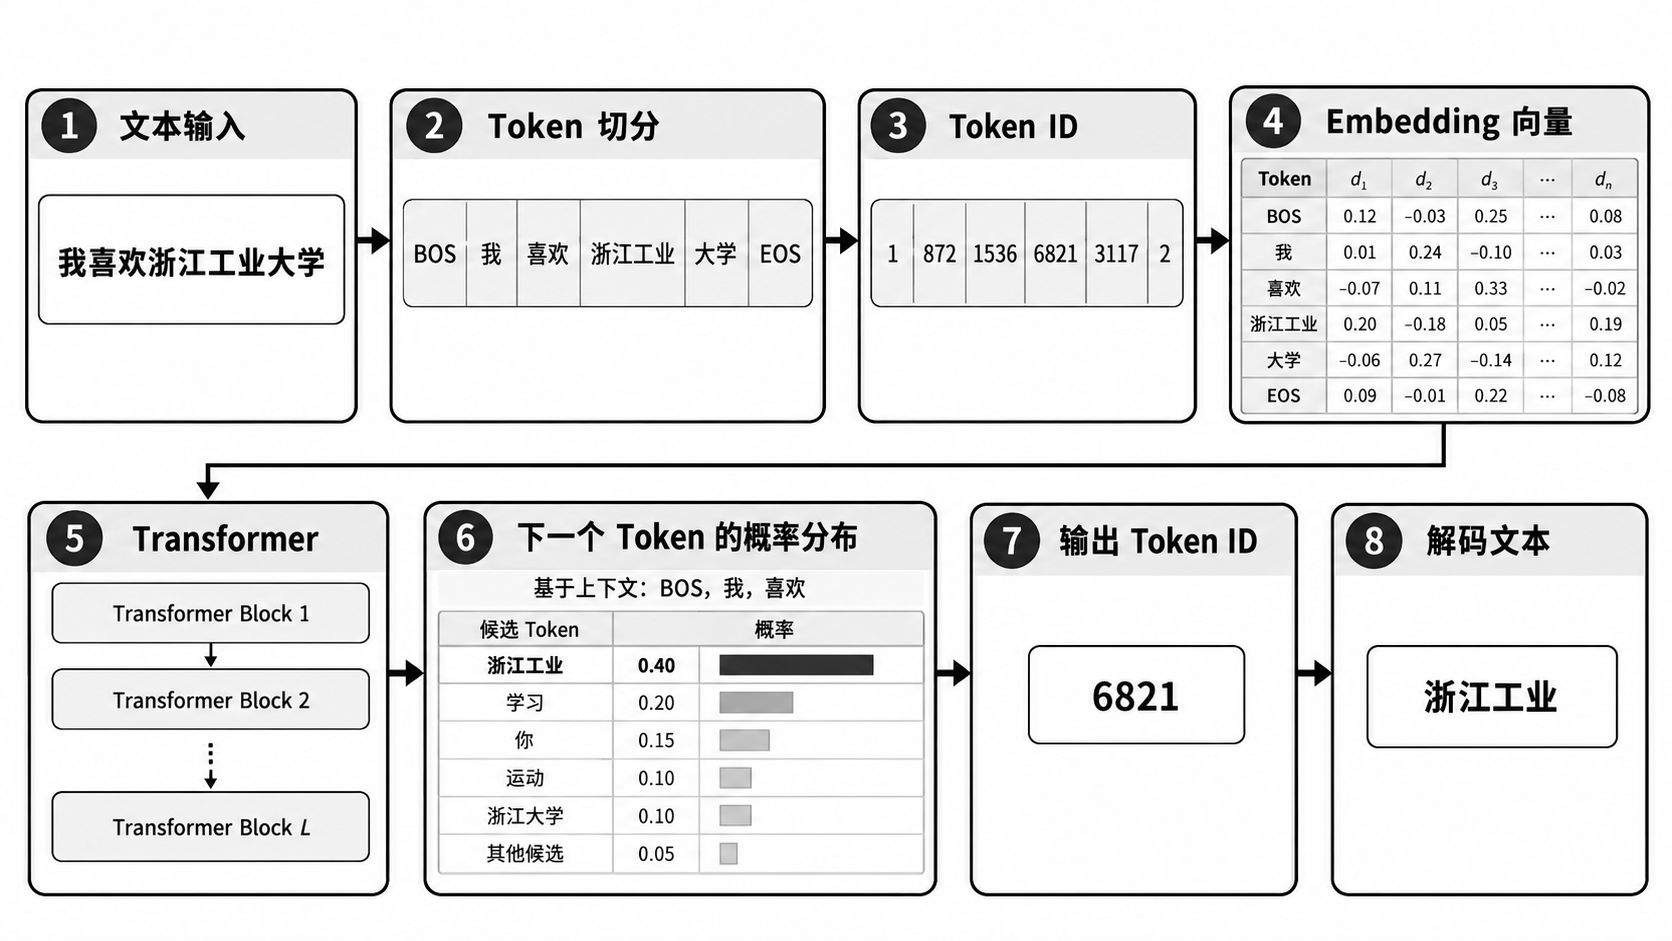
本部分最重要的结论是:Transformer 接收的不是未经处理的句子,而是经过 Tokenizer 转换、再经 Embedding 映射得到的向量序列;语言模型训练时,则通过预测下一个 Token 来调整这些向量和网络参数。
2. 公式与符号说明
本部分旨在帮助读者认出公式里的记号、索引和形状写法。具体数学概念会在数学基础章节独立讲解。机器学习领域没有一份适用于所有教材和论文的固定符号表,同一字母可能在不同语境表示不同对象,本文仅对部分约定俗成的符号进行介绍以及讲解。可选择性阅读。
2.1 标量、向量及矩阵
| 对象 | 写法 | 示例 |
|---|---|---|
| 标量 | 普通小写字母 | $x$、$y$、$\eta$ |
| 向量 | 粗体小写字母 | $\mathbf{x}$、$\mathbf{h}$ |
| 矩阵 | 大写字母 | $X$、$W$、$Q$ |
| 高维张量 | 花体大写字母 | $\mathcal{X}\in\mathbb{R}^{B\times L\times d}$ |
| 随机变量 | 通常用大写字母;具体观测值用对应小写字母 | 随机变量 $X$,观测值 $x$ |
向量的分量用普通字母和下标表示。例如,$\mathbf{x}$ 是一个向量,$x_j$ 是它的第 $j$ 个分量。矩阵 $X$ 的元素 $X_{ij}$ 则表示第 $i$ 行、第 $j$ 列的数。
在本文中,单个 Token 的嵌入表示为一个行向量。若向量维度为 $d_{\text{model}}$,则 $\mathbf{e}^{(i)} \in \mathbb{R}^{1 \times d_{\text{model}}}$。一条包含 $L$ 个 Token 的序列,把这些向量逐行堆叠成矩阵 $X \in \mathbb{R}^{L \times d_{\text{model}}}$。因此,$X_{ij}$ 表示第 $i$ 个 Token 在第 $j$ 个特征维度上的数值。
2.2 上标、下标与索引
上标和下标的含义由对象及上下文决定,不能把它们机械地理解成同一种编号。不过一般来说,下标常用来标记分量或位置;带括号的上标常用来标记样本或向量编号。因此本文约定:
- 数据集中的第 $n$ 个样本写作 $\mathbf{x}^{(n)}$、$y^{(n)}$。圆括号里的上标表示样本编号,不是乘方。
- 向量第 $n$ 个样本的第 $j$ 个分量写作 $x_j^{(n)}$。
- 矩阵的第 $i$ 行、第 $j$ 列元素写作 $X_{ij}$。
- 序列中第 $i$ 个 Token 写作 $t_i$;它的 Token ID 写作 $\operatorname{id}(t_i)$。
- 第 $\ell$ 层、第 $i$ 个序列位置的隐藏向量可写作 $\mathbf{h}^{(\ell,i)}$;其中第 $j$ 个分量是 $h_j^{(\ell,i)}$。
- $x^2$ 中的上标表示平方;$\mathbf{x}^{\top}$ 中的 $\top$ 表示转置。
2.3 数据、标签、预测、参数
| 符号 | 含义 | 符号 | 含义 |
|---|---|---|---|
| $\mathbf{x}^{(n)}$ | 第 $n$ 个输入样本或输入向量 | $y^{(n)}$ | 第 $n$ 个样本对应的目标答案或标签 |
| $\hat{y}^{(n)}$ | 模型对第 $n$ 个样本的预测;帽子表示预测值 | $\mathcal{D}$ | 数据集 |
| $N$ | 样本数量 | $f_{\theta}$ | 参数为 $\theta$ 的模型或函数 |
| $\theta$ | 模型全部可学习参数的统称 | $W$ | 权重矩阵;具体用途常用下标标明,如 $W_Q$ |
| $b$ | 偏置参数 | $\mathbf{h}$ | 隐藏表示或中间向量 |
一组带标签的数据可以写成:
$$
\mathcal{D}={(\mathbf{x}^{(n)},y^{(n)})}_{n=1}^{N}
$$
模型根据输入产生预测,可以写成:
$$
\hat{y}^{(n)}=f_{\theta}(\mathbf{x}^{(n)})
$$
其中, $\mathcal{D}$ 表示数据集;圆括号上标 $(n)$ 表示第 $n$ 个样本。
2.4 形状、维度、集合
| 记号 | 含义 |
|---|---|
| $\mathbf{x}\in\mathbb{R}^{d}$ | 一个含 $d$ 个实数分量的向量 |
| $X\in\mathbb{R}^{m\times n}$ | 一个 $m$ 行、$n$ 列的矩阵 |
| $X\in\mathbb{R}^{L\times d_{\text{model}}}$ | 一条长度为 $L$ 的序列表示,每个 Token 有 $d_{\text{model}}$ 个特征 |
| $\mathcal{X}\in\mathbb{R}^{B\times L\times d_{\text{model}}}$ | 一批序列表示,三个轴依次为批次、序列位置和特征 |
本文主要使用以下维度符号:
| 符号 | 含义 |
|---|---|
| $B$ | 批次大小,即一次处理的样本或序列数量 |
| $L$ | 序列长度,即序列中 Token 的数量 |
| $d$ | 一般的特征维度 |
| $d_{\text{model}}$ | Transformer 中每个 Token 的隐藏表示维度 |
| $H$ | 注意力头数 |
| $d_k,d_v$ | 每个注意力头中 Key/Query 与 Value 的维度 |
| $N_{\text{vocab}}$ | 词表大小 |
2.5 常见运算符
| 记号 | 读法或作用 |
|---|---|
| $=$、$:=$ | 等于、定义为 |
| $\approx$、$\propto$ | 约等于、成正比 |
| $\in$、$\forall$、$\exists$ | 属于、对所有、存在 |
| $\sum_{i=1}^{N}$、$\prod_{i=1}^{N}$ | 求和、求积 |
| $(\cdot)^\top$ | 转置 |
| $\mathbf{x}^{\top}\mathbf{y}$ | 向量点积 |
| $\odot$ | 逐元素相乘 |
| $|\mathbf{x}|_2$ | 向量的二范数 |
| $\partial$、$\nabla_\theta$ | 偏导数、对参数 $\theta$ 求梯度 |
| $\max$、$\min$ | 最大值、最小值 |
| $\operatorname{argmax}$、$\operatorname{argmin}$ | 使目标值达到最大、最小的输入 |
| $\mathbb{1}[A]$ | 指示函数;条件成立时为 $1$,否则为 $0$ |
| $\log$、$\exp$、$\operatorname{softmax}$ | 对数、指数函数、Softmax 函数 |
| $\leftarrow$、$\to$ | 赋值/更新、映射或趋向;具体含义看上下文 |
2.6 概率、条件、期望
| 记号 | 含义 |
|---|---|
| $P(A)$ | 事件 $A$ 发生的概率 |
| $p(x)$ | $x$ 的概率分布;连续变量时也可表示概率密度 |
| $p(y\mid x)$ | 给定 $x$ 时,$y$ 的条件分布 |
| $x\sim p(x)$ | 从分布 $p(x)$ 中抽取一个 $x$ |
| $\mathbb{E}[\cdot]$ | 期望;对随机抽取的结果按其分布求平均 |
概率论教材常用大写 $X$ 表示随机变量、小写 $x$ 表示具体取值;机器学习文献中,期望下标也常直接用小写变量表示“从某分布抽取的样本”。本文在期望记号中使用后一种写法,并在下标中标出抽样来源。
单个变量的期望:
$$
\mathbb{E}{x\sim p{\text{data}}(x)}[g(x)]
$$
表示从数据分布 $p_{\text{data}}(x)$ 中抽取 $x$,再对 $g(x)$ 求平均。
多个变量可以一起出现在期望下标中。若一对变量从联合分布中抽取:
$$
\mathbb{E}_{(x,y)\sim p(x,y)}[g(x,y)]
$$
这里 $x$ 和 $y$ 可以相关。如果它们分别从两个独立分布中抽取,可以写作:
$$
\mathbb{E}_{x\sim p(x),,y\sim q(y)}[g(x,y)]
$$
如果 $y$ 的抽样分布取决于 $x$,则应写明条件分布:
$$
\mathbb{E}{x\sim p(x)}
\left[
\mathbb{E}{y\sim q(y\mid x)}[g(x,y)]
\right]
$$
因此,$\mathbb{E}_{x,y}$ 只列出了参与取期望的变量;若分布关系还不明确,就需要补充联合分布、各自的抽样分布或条件分布。例如,$\epsilon\sim\mathcal{N}(0,I)$ 表示噪声 $\epsilon$ 从均值为 $0$、协方差为单位矩阵 $I$ 的正态分布中抽取。
机器学习中常用有限样本的平均估计总体期望:
$$
\mathbb{E}{x\sim p{\text{data}}(x)}[g(x)]
\ \approx
\frac{1}{N}\sum_{n=1}^{N}g(x^{(n)})
$$
左边是对数据分布取期望,右边是用 $N$ 个样本计算出的经验平均。
2.7 损失、梯度、参数更新
经验风险可以写为:
$$
\mathcal{L}(\theta) = \frac{1}{N}\sum_{n=1}^{N}\ell\left(f_{\theta}(\mathbf{x}^{(n)}),y^{(n)}\right)
$$
最基本的梯度下降更新记作:
$$
\theta \leftarrow \theta-\eta\nabla_{\theta}\mathcal{L}(\theta)
$$
这里 $\ell$ 和 $\mathcal{L}$ 不是同一个层级的量:前者可以表示单个样本的损失,后者通常把多个样本的损失汇总起来。实际用的是求和还是平均,要看公式如何定义。
###2.8 Transformer 中常见的符号
| 符号 | 含义 |
|---|---|
| $t_i$ | 序列第 $i$ 个 Token |
| $\operatorname{id}(t_i)$ | 位置 $i$ 上 Token 对应的整数 ID |
| $E$ | Embedding 矩阵,形状通常为 $N_{\text{vocab}}\times d_{\text{model}}$ |
| $\mathbf{e}^{(k)}$ | Token ID 为 $k$ 时查到的嵌入向量 |
| $X$ | 输入序列的表示矩阵;每一行对应一个 Token 位置 |
| $W_Q,W_K,W_V$ | 将输入投影为 Query、Key、Value 的权重矩阵 |
| $Q,K,V$ | Query、Key、Value 矩阵 |
| $S$ | 注意力分数矩阵 |
| $A$ | Softmax 后的注意力权重矩阵 |
| $M$ | 注意力掩码 |
| $O$ | 注意力计算得到的输出表示 |
| $\mathbf{z}$ | 输出层产生的 Logits 向量,即 Softmax 前的分数 |
| $\mathbf{p}$ | 候选 Token 的概率向量,常写作 $\mathbf{p}=\operatorname{softmax}(\mathbf{z})$ |
| $\hat{t}_{i+1}$ | 模型或解码策略选出的下一个 Token |
| $\tau$ | 生成时的 Temperature 参数 |
对于词表中第 $j$ 个候选 Token,$z_j$ 表示对应的 Logit,$p_j$ 表示 Softmax 后的概率。语言模型给定前文时的条件分布可写作:
$$
p_{\theta}(t_{i+1}\mid t_1,\ldots,t_i)
$$
若序列长度为 $L$,单头注意力的一种常见形状约定为:
$$
X\in\mathbb{R}^{L\times d_{\text{model}}},
\quad
Q,K\in\mathbb{R}^{L\times d_k},
\quad
V\in\mathbb{R}^{L\times d_v}
$$
于是 $QK^\top$ 的形状是 $L\times L$,表示每个序列位置与其他位置之间的分数。批量输入增加批次轴 $B$;多头注意力增加头数轴 $H$。后文会推导这些形状如何产生。
3. 数学基础
本不放呢旨在补充部分线性代数、微积分、概率论的数学基础知识以讲解后续机器学习、神经网络以及 Transformer 会实际用到的数学工具,可选择性阅读。

